 ModelFold
omnihuman-1-5
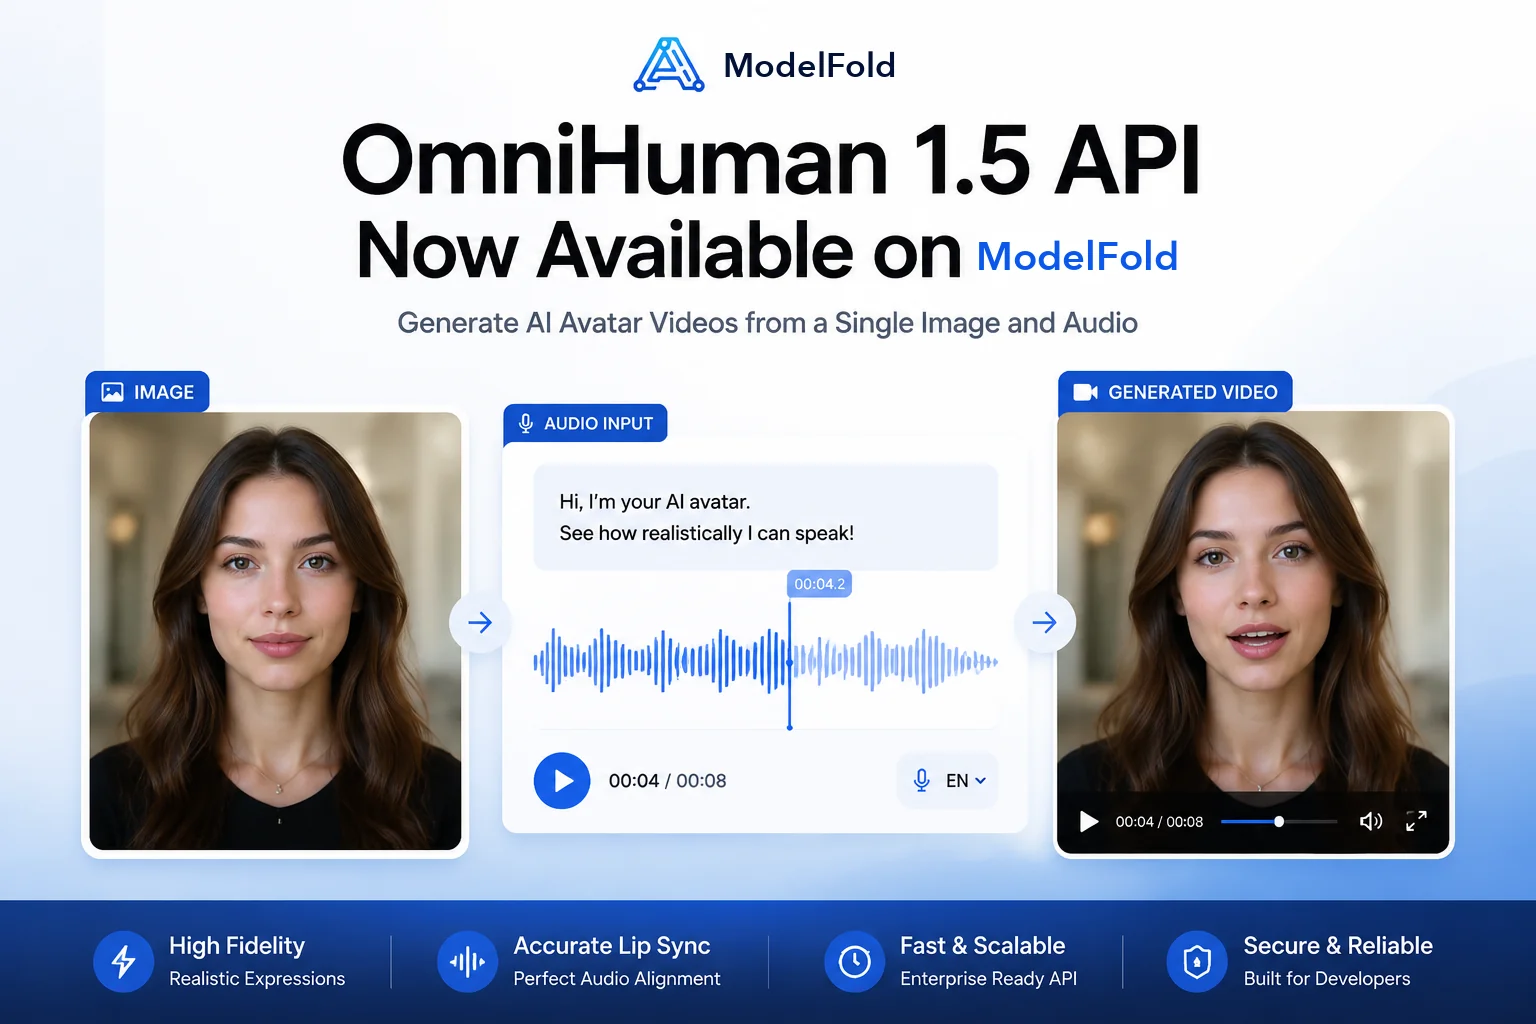
ByteDance OmniHuman 1.5 API を使い、1 枚の画像と音声から、リアルな AI アバター動画、リップシンク動画、デジタルヒューマンコンテンツを生成できます。
料金: 長さにかかわらず 1 回あたり 176 クレジット。
Playground
モデル仕様に合わせて入力済みです。そのまま実行するか、項目を調整してください。
このバリアントのサンプルです。「実行」で自分の作品を生成できます。
ほかの 動画 モデルを探す
ByteDance のほかの AI モデル
新着・人気の AI モデル
OmniHuman 1.5 API
ByteDance OmniHuman 1.5 API を使い、1 枚の画像と音声から、リアルな AI アバター動画、リップシンク動画、デジタルヒューマンコンテンツを生成できます。
モデルとバリエーション
タスクに合うモデルの種類を選択してください。Playground では、選択したバリエーションのパラメータと例を使用します。
Omnihuman 1 5
モデル ID: omnihuman-1-5。送信前に、このバリエーションの必須入力と対応する参照形式を確認してください。
Human Identification
モデル ID: omnihuman-1-5/human-identification。送信前に、このバリエーションの必須入力と対応する参照形式を確認してください。
Subject Detection
モデル ID: omnihuman-1-5/subject-detection。送信前に、このバリエーションの必須入力と対応する参照形式を確認してください。
使い方
- 1
バリエーションを選択
ページ上部でモデルの種類を選び、料金と入力要件を確認してください。対応する参照メディアや出力は、バリエーションによって異なる場合があります。
- 2
入力を準備
Playground の各項目に入力し、必要な画像・動画・音声を用意して、利用できるパラメータを調整してください。例は操作の流れを示すものです。参照素材には、使用権限のあるものを使ってください。
- ✓
結果を確認
ログインしてタスクを送信し、完了後に結果をプレビューまたはダウンロードしてください。タスクの状態はアカウントのログで確認できます。自動化する場合は、以下の API の例とモデルのドキュメントを参照してください。
パラメータと料金
料金表には現在の ModelFold の料金が表示されます。料金は選択したバリエーションと課金パラメータによって決まります。サイズ、解像度、長さ、参照メディア、出力数が料金に影響するのは、モデルの課金ルールで指定されている場合のみです。送信前に Playground の見積もりと残高を確認してください。 選択したバリエーションのモデル ID と入力項目を使用してください。画像・動画・音声のタスクでは入力内容が異なります。非同期タスクでは、結果を待っている間に再送信せず、状態の更新を待ってください。
よくある質問
例は自動で生成されますか?⌄
例はあらかじめ用意されたデモ素材です。ページの閲覧やバリエーションの切り替えでは、コンテンツは生成されません。タスクを送信するとモデルが呼び出され、表示料金に応じてクレジットが消費されます。
パラメータはどのように選べばよいですか?⌄
まずモデルの種類を選び、フォームで必要な項目と参照素材を入力してください。対応する解像度、長さ、入力制限は、すべてのバリエーションで共通とは限りません。
どのように連携できますか?⌄
アカウントで API キーを作成し、API の例とモデルのドキュメントに従ってください。キーはサーバー側で保管し、ブラウザーのコードや公開リポジトリに含めないでください。
| Omnihuman 1 5 | 176 クレジット 1 回あたり |
1 回ごとの固定料金で、動画の長さには左右されません。
curl https://modelfold.ai/v1/videos/generations \
  -H "Authorization: Bearer $MODELFOLD_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"omnihuman-1-5","prompt":"...","resolution":"720p","duration":5}'